Muntatge de transcriptoma de Novo basat en RNA-Seq i descobriment de gens de la tija carnosa de Cistanche Deserticola-Ⅰ
Sep 03, 2024
Fons
Cistanche deserticola és una planta parasitària completament no fotosintètica amb un gran valor medicinal i es distribueix principalment al desert del nord-oest de la Xina. La seva tija carnosa seca és un tònic crucialmedicina tradicional xinesaamb funcions principalment de millorar la funció sexual masculina i enfortir la immunitat, però s'han realitzat pocs estudis mecanicistes en part a causa de la manca de recursos genòmics i transcriptòmics.

NATURAL CISTANCHE TUBULOSA MEDICINA TRADICIONAL XINESA PHGS75% ECH 30% ACT 12%
Resultats
En aquest estudi, vam realitzar una seqüenciació profunda del transcriptoma a la tija carnosa de C. deserticola i es van generar uns 80 milions de lectures mitjançant la seqüenciació de parells d'Illumina a la plataforma HiSeq2000. Mitjançant l'assemblador de la trinitat, vam obtenir 95.787 seqüències de transcripció amb longituds de transcripció que oscil·laven entre 200 pb i 15.698 pb, amb una longitud mitjana de 950 bases i una longitud N50 de 1.519 bases. Es van identificar 63.957 transcripcions expressades activament amb FPKM superior o igual a 0, 5, en què es van anotar 30.098 transcripcions amb descripcions de gens o termes d'ontologia gènica mitjançant anàlisis de similitud de seqüències contra diverses bases de dades públiques (Uniprot, NR i Nt a NCBI i KEGG) . A més, vam identificar gens enzimàtics clau implicats en la biosíntesi de lignina i glicòsids feniletanoides (PhGs) que se sap que són els ingredients actius primaris. Es van identificar quatre gens de fenilalanina amoníaco-liasa (PAL), el primer enzim clau en la biosíntesi de lignina i PhG a partir de la comparació de seqüències i l'anàlisi filogenètica. També es van proposar per primera vegada dues vies de biosíntesi de PhG.
Conclusions
En total, vam completar una anàlisi global del transcriptoma de la tija carnosa de C. deserticola mitjançant la tecnologia RNA-seq. Es va identificar una col·lecció de gens enzimàtics relacionats amb la biosíntesi de lignina i glicòsids feniletanoides a partir de les transcripcions reunides i anotades, i també es va predir la família de gens de PAL. Les dades de la seqüència d'aquest estudi proporcionaran un recurs valuós per dur a terme futures investigacions sobre la biosíntesi de glicòsids feniletanoides i estudis genòmics funcionals en aquesta important planta medicinal.
Introducció
C. deserticola és un gènere mundial de plantes desèrtiques perennes de la família de les Orobanchaceae i és una espècie completament no fotosintètica i normalment creix una planta holoparàsita subterrània. Està parasitat a les arrels del psamòfit Haloxylon ammodendron (Chenopodiaceae), que habita principalment en deserts i semideserts per la seva alta tolerància a la sequera i la salinitat. C. deserticola mostra una forta resistència a les dures condicions ambientals i es distribueix principalment al nord-oest de la Xina, especialment a Mongòlia Interior, Gansu i Xinjiang. Es considera que és una espècie salvatge en perill d'extinció en els darrers anys a causa de l'augment del consum per part dels humans. C. deserticola, que sovint s'anomena ginseng del desert, es coneix comunament com a ginesta del desert i la tija carnosa seca s'ha utilitzat àmpliament com a tònic tradicionalment important a la Xina i el Japó durant molts anys. Es va registrar inicialment a Shen Nong Ben Cao Jing (Diccionari de la matèria mèdica xinesa, 1977) fa aproximadament 1800 anys i es va considerar com una de les principals fonts de laHerba medicinal xinesa Cistanche.

TUBULOSA NATURAL DE CISTANCHE PER A LA MILLORA DE LA FUNCIÓ SEXUAL PHGS75% ECH 30% ACT 12%
Els extractes de C. deserticola posseeixen un ampli ventall de funcions medicinals, especialment per al seu ús en la millora de la funció sexual, la tonificació dels ronyons, la protecció del fetge, l'activitat aperitiva, la millora de la memòria, l'activitat immunomoduladora, antioxidant, antiinflamatòria, antiviral, etc. Els principals components bioactius de C. deserticola són glicòsids feniletanoides (PheGs, PhGs). Fins ara, s'han aïllat més de 20 glicòsids feniletanoides de la tija suculenta de C.deserticola. Entre ells,acteòsid i equinacòsidsón dos components principals amb activitats farmacològiques importants i estan documentats com els estàndards de qualitat de C. deserticola a la farmacopea xinesa (edicions 2005 i 2010). Tres components químics dels PhG són l'àcid orgànic, el sacàrid i el feniletanoide, però, els detalls sobre les vies biosintètiques dels feniletanoides segueixen sent poc coneguts a C.deserticola.
Malgrat la importància comercial i medicinal de C.deserticola, les dades genòmiques i transcriptòmiques d'aquesta espècie són molt limitades. No hi ha EST disponibles a la base de dades NCBI i la informació completa del genoma d'aquesta espècie no està disponible excepte per a la seqüència del genoma del cloroplast. Les dades transcriptòmiques limitades dificulten l'estudi dels mecanismes biosintètics de PhG. La tecnologia RNA-seq pot generar seqüències de les parts expressades del genoma objectiu i identificar gens [18] mitjançant les plataformes tecnològiques NGS (com Applied Biosystems SOLiD, Illumina HiSeq i Roche 454). Cada cop és més popular en el muntatge de transcriptoma de novo, ja que és un enfocament rendible i potent amb alta resolució i ampli rang dinàmic, sobretot perquè té l'avantatge d'explorar transcripcions de poca abundància. A causa dels diversos avantatges, l'ARN-seq és especialment atractiu per a organismes no models amb recursos genètics limitats. Tanmateix, no hi ha cap investigació detallada sobre el transcriptoma de C. deserticola per ARN-seq.
En aquest estudi, vam seqüenciar globalment el transcriptoma de la tija de C. deserticola mitjançant la plataforma Illumina Hiseq2000 i vam obtenir dades en brut de 7,9 G. Mitjançant el muntatge i l'anotació, vam extreure els gens implicats en la biosíntesi de PhG i els gens responsables de la biosíntesi completa de la lignina. La nostra anàlisi d'ARN-seq va generar el primer transcriptoma de consens de C. deserticola i va proporcionar noves idees sobre una comprensió integral del valor medicinal de C. deserticola. A més, el mètode descrit aquí es pot aplicar àmpliament als transcriptomes de perfil per facilitar el descobriment de gens implicats en vies de biosíntesi de components medicinals específics en una altra planta medicinal amb recursos genòmics molt limitats.
Materials i mètodes
Recollida de material vegetal
La tija suculenta fresca de C. deserticola en l'etapa d'excavació es va recollir d'una base vegetal a BayanHot City of Alxa League a Mongòlia Interior al nord-oest de la Xina. El permís de recollida es va obtenir del propietari (HongKui CongRong Group) de la base de la planta. L'exemplar del val es va dipositar a la instal·lació genòmica bàsica de l'Institut de Genòmica de Beijing, Acadèmia Xinesa de Ciències. Després de la neteja, els teixits de la tija suculenta es van tallar en trossos petits i es van congelar immediatament en nitrogen líquid, i després es van emmagatzemar a -80 graus fins a un posterior processament.
Extracció d'ARN, construcció de biblioteques d'ADNc i seqüenciació d'Illumina
L'ARN total es va extreure de la tija suculenta mitjançant TRIzol Reagent (Invitrogen Inc., Califòrnia, EUA) segons les instruccions del fabricant. Les mostres resultants es van tractar amb DNasa I per eliminar qualsevol ADN genòmic. Els ARN extrets es van quantificar mitjançant un bioanalitzador Agilent 2100 (Agilent Technologies) i es van comprovar la integritat mitjançant electroforesi en gel d'agarosa desnaturalitzant amb tinció de bromur d'etidi. En les anàlisis posteriors es van utilitzar mostres d'ARN amb proporcions A260/A280 entre 1,9 i 2,1, proporcions ARN 28S:18S superiors a 1,0 i números d'integritat de l'ARN (RIN) -8.5.
Les biblioteques d'ARN-seq es van generar mitjançant kits de preparació de mostres d'ARN Illumina Truseq. L'ARN Poly (A) + es va aïllar de l'ARN total mitjançant perles Dynal ligo (dT) 25 segons les instruccions del fabricant. Després de la purificació, es va afegir un tampó de fragmentació per trencar l'ARNm en fragments curts. L'ADNc de la primera cadena es va sintetitzar utilitzant aquests fragments curts com a plantilles, juntament amb la transcriptasa inversa SuperScript III i el cebador hexàmer aleatori N6. L'ADNc de la segona cadena es va sintetitzar mitjançant tampó, dNTPs, RNasaH i ADN polimerasa I. L'ADNc de doble cadena resultant es va sotmetre a una reparació final mitjançant l'ADN polimerasa T4, el fragment Klenow de l'ADN polimerasa I i la polinucleòtid quinasa T4 i es va lligar a adaptadors que utilitzen ADN lligasa T4. Els fragments lligats amb l'adaptador es van purificar mitjançant un kit d'extracció de PCR QiaQuick i es van eluir amb tampó EB. Després de l'anàlisi mitjançant electroforesi en gel d'agarosa, es van seleccionar fragments adequats com a plantilles per a l'amplificació per PCR. La seqüenciació de la biblioteca d'ADNc resultant es va dur a terme amb un sistema Illumina HiSeq 2000.
Ensamblatge de transcripcions de novo i quantificació de l'expressió gènica
Les lectures en brut generades a partir de la seqüenciació es van netejar eliminant les seqüències de l'adaptador (ATCTCGTATGCCGTC) mitjançant un mètode intern. Després vam dur a terme un procés de filtrat de baixa qualitat estricte. En primer lloc, les bases amb una puntuació de qualitat de phred inferior a 20 es retallarien des del final 3' de la seqüència, fins a trobar una base amb una qualitat superior (Més o igual a 20). Si la longitud de lectura fos inferior a 50 pb, es descartaria. En segon lloc, les lectures es filtraran encara més segons el criteri que el 70% de les bases d'una lectura tinguin puntuacions d'alta qualitat (més o igual a 20). En tercer lloc, només es van utilitzar lectures d'extrem aparellat per a un posterior muntatge. El muntatge de la transcripció de novo es va dur a terme mitjançant la versió de Trinity_20130216 [30] que constava de tres mòduls de programari successius: Inchworm, Chrysalis i Butterfly. Els paràmetres de muntatge es van establir de la següent manera: -seqType fq-JM 300G -min_contig_longitud 200-CPU 20-inchworm_cpu {{21} }bflyCPU 20.
Per quantificar l'abundància de transcripcions, les lectures de parelles seqüenciades es van tornar a alinear a les transcripcions reunides mitjançant un script a Trinity. Les lectures mapejades es van utilitzar per a la quantificació mitjançant el programari RSEM (RNA-Seq by Expectation Maximization). L'abundància de gens o isoformes es va representar pel valor del fragment per quilobase de transcripció per milió de fragments mapats (FPKM), aquelles transcripcions amb valor FPKM igual o superior a 0,05 es van definir tal com s'expressa.
Anotació funcional de transcripcions expressades
No hi ha cap conjunt d'anotacions gèniques de C. deserticola excepte el genoma del cloroplast [1]. Hem anotat les transcripcions expressades comparant-les amb els conjunts de dades actualitzats Genbank Nt, Genbank Nr i TAIR10_ pep_20101214_ per separat mitjançant el programa BLAST (E< = 1e-20). Meanwhile, all expressed transcripts were translated into potential proteins according to ORF prediction by TransDecoder and predicated for the conserved domains based on the Pfam database.
Anotació de l'ontologia gènica i la via KEGG Mitjançant l'alineació de semblança de seqüències a la base de dades Uniprot (l'anotació d'ontologia gènica (GO) de totes les transcripcions reunides es va obtenir mitjançant un fitxer d'associació descarregat de (ftp://ftp.ebi.ac.uk/pub/). databases/GO/goa/UNIPROT/gene_associació goa_uniprot.gz es va fer l'agrupació de termes GO de gens expressats mitjançant scripts personalitzats i vam anotar els gens al quart nivell. Categories CC, BP i MF per separat.
La informació de la via KEGG es va assignar per a totes les seqüències de proteïnes previstes mitjançant l'eina en línia KAAS (KEGG Automatic Annotation Server) [34]. Les seqüències en format fasta es van enviar a la sol·licitud de KAAS i es van descarregar els fitxers resultants de tota la informació de les vies relacionades amb el transcriptoma de la tija de C. deserticola. Es van utilitzar 13 conjunts de dades de gens d'organismes vegetals a KEGG per a l'anotació mitjançant el mètode BBH (millor èxit bidireccional).

NATURAL CISTANCHE TUBULOSA CISTANCHE EXTRACTE PHGS75% ECH 30% ACT 12%
Anàlisi RT-qPCR
Després de la digestió amb DNasa I, aproximadament 5 ug d'ARN total es van convertir en ADNc de primera cadena mitjançant la reacció de transcripció inversa amb primers oligo (dT) 15 i el sistema de transcripció inversa GoScript (Promega). Els productes d'ADNc es van diluir 10-plegament amb aigua desionitzada sense nucleases abans d'utilitzar-los com a plantilla en PCR en temps real. Els ADNc específics es van amplificar amb el sistema GoTaq 2-Step RT-qPCR (Promega) en un volum de 20 ul. L'amplificació per PCR es va realitzar a la temperatura de recuit de 60 graus amb el sistema de detecció de PCR en temps real 7500 (Applied Biosystems) segons les instruccions del fabricant. Les abundàncies de transcripcions relatives es van calcular mitjançant el mètode de llindar de cicle comparatiu amb el gen "comp10579_c0" com a estàndard intern, utilitzant el programari 7500 Manager.
Els parells de primers per a RT-PCR es van dissenyar basant-se en programari en línia (http://primer3.ut.ee/) i es mostren al conjunt de dades S1.
Resultats
Seqüenciació d'ARN i assemblatge de transcriptoma de novo de tija carnosa de C. deserticola
La tija de C. deserticola s'ha utilitzat àmpliament com a tònic tradicionalment important a la Xina i el Japó durant molts anys. Per obtenir una visió global de l'expressió gènica a la tija carnosa de C. deserticola, vam recollir mostres de tija de C. deserticola de la mateixa base vegetal el 2013 i el 2014, respectivament. Es van extreure els ARN totals i es van purificar els ARN poliA + per construir biblioteques d'ARN-seq d'extrems aparellats. Es van obtenir 79.433.734 i 86,019.176 lectures de parells corresponents a prop de 8.000 milions i 8.600 milions de bases de la seqüència mitjançant la seqüenciació Illumina HiSeq 2000

plataforma en mostres d'{0}}anys i 2014-anys (taula 1). Després d'eliminar les seqüències d'adaptadors i filtrar lectures de baixa qualitat (vegeu els detalls a Mètodes), es van utilitzar 64.831.040 lectures de final de parell d'alta qualitat a la mostra de 2013-any per al muntatge de transcriptoma de novo. Mitjançant l'assemblador de seqüències Trinity [30], es van generar 51.719 gens i 95.787 seqüències de transcripció amb longituds de transcripció que oscil·laven entre 200 pb i 15.698 pb. La longitud mitjana de les transcripcions reunides és de 950 bases i la longitud de N50 és de 1.519 bases. El nombre de transcripcions de diferents longituds va revelar que el 57, 32% de les transcripcions reunides tenien uns 500 pb o més (Fig 1A). Les lectures de parelles d'alta qualitat a la mostra de 2014-any es van assignar al transcriptoma muntat. A més, vam trobar que el nombre de transcripcions per a cada gen reunit variava i el 69% dels gens amb una isoforma expressada mentre que el 31% dels gens expressaven dues o més transcripcions (Fig 1B).
Quantificació d'expressió i anotació funcional de transcripcions reunides
L'abundància de gens o transcripcions es va quantificar mitjançant el paquet RSEM, en què les lectures seqüenciades es van tornar a alinear amb els gens reunits o les seqüències de transcripcions mitjançant Bowtie, i es van utilitzar aquestes lectures mapeades per a la quantificació. Es va calcular el valor FPKM per a cada gen o transcripció i, finalment, vam identificar 63.957 i 52.857 transcripcions expressades activament (valor FPKM superior o igual a 0,5) en mostres de tija carnosa de C. deserticola en 2{{17} }13 i 2014, respectivament. 44.776 transcripcions (70,01% a la mostra 2013-any, 84,71% a la mostra 2014-any) es van expressar habitualment en les dues rèpliques, i la correlació (coeficient de correlació de Pearson: 0,91979) de les seves dades d'expressió era mostrat a la figura S1. Les dades brutes de seqüenciació s'havien carregat a la base de dades NCBI SRA (números d'accés: SRX857402 i SRX858938). Hem utilitzat gens expressats identificats a la mostra de 2013-anys per a una anàlisi posterior. La informació d'anotació funcional per a totes les transcripcions expressades es va obtenir mitjançant dos mètodes. En primer lloc, totes les transcripcions expressades es van alinear a bases de dades conegudes de nucleòtids (GenBank nt) i de seqüències de pèptids (GenBank nr i pèptid d'Arabidopsis) per separat mitjançant l'algorisme BLAST. De 63.957 transcripcions expressades,

29.220 (45, 7%) van ser anotats i van mostrar homologia amb seqüències de qualsevol de les tres bases de dades subjectes amb el tall de valor E 1e-20. Mentrestant, les regions de codificació candidates per a totes les seqüències de transcripció expressades es van predir mitjançant el programari TransDecoder i es van utilitzar els ORF més llargs per a cada transcripció per a la cerca del domini Pfam. Com a resultat, es van anotar 21.358 (33,4%) transcripcions basades en la base de dades Pfam. En total, 30.098 (47,1%) transcripcions es van relacionar significativament amb gens coneguts a les bases de dades públiques combinant els dos mètodes anteriors. La llista completa de transcripcions expressades amb anotació de funcions es va mostrar en dades suplementàries (conjunt de dades S2).
Vam enquestar les 20 transcripcions més altament expressades (taula 2) corresponents al 18,99% de totes les lectures de seqüenciació i vam trobar que la majoria d'elles són gens que responen a abiòtics.
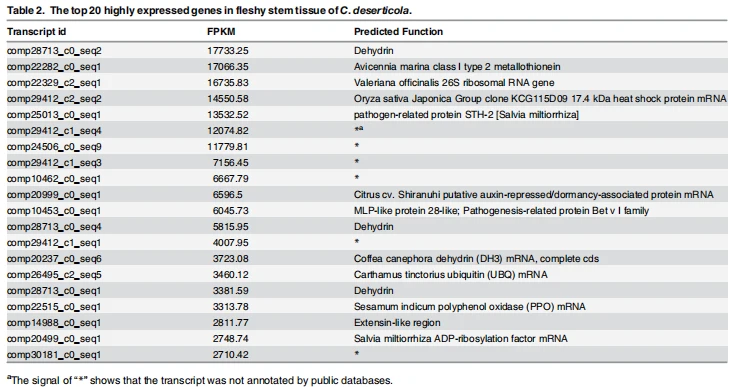
estímul de l'estrès. La dehidrina (DHN), una classe de proteïnes d'estrès hidròfiles i termoestables amb un gran nombre d'aminoàcids carregats que pertanyen a la família d'abundants d'embriogènesi tardana (LEA) del Grup II, és el gen més expressat. Es van detectar tres transcripcions de Dehyrin diferents (comp28713_c0_seq1/2/4) com altament expressades en tiges carnoses que poden estar implicades en la protecció de les cèl·lules dels danys causats per l'estrès per sequera. També es van trobar altres gens relacionats amb l'estrès, com ara la proteïna de xoc tèrmic, la proteïna relacionada amb patògens i la metalotioneïna, que poden estar relacionats amb el seu entorn de supervivència greu. A més, alguns gens constitutius que inclouen el gen de l'ARN ribosòmic 26S (comp22329_c{2_seq1), proteïna reprimida per auxina/associada a la latència (comp{20999_c{0_seq1), El factor de ribosilació ADP (comp20499_ c0_seq1) també es va transcriure molt.

TUBULOSA NATURAL DE CISTANCHE PER A LA MILLORA DE LA IMMUNITAT PHGS75% ECH 30% ACT 12%